Em mais de 10 anos sustentando ambientes Linux e infraestruturas de nuvem em produção, raramente vi um desperdício financeiro tão brutal quanto o aluguel contínuo de instâncias de GPU dedicadas para aplicações com tráfego irregular.
Muitas equipes sobem uma máquina virtual com GPU. Na tabela de preços da Lambda, consultada em outubro de 2026, um H100 sai por US$ 3,29 a US$ 4,29 por GPU/hora e um A100 por US$ 1,99 a US$ 2,79. Se a aplicação atende clientes só em horário comercial — 8 horas por dia útil —, a placa fica parada em cerca de três quartos das 730 horas do mês. Mantido ligado 24/7, um H100 a US$ 3,99/hora custa perto de US$ 2.900 por mês; um A100 de 80 GB, cerca de US$ 2.040.
Para quebrar essa armadilha de custos, a DigitalOcean desenvolveu a sua plataforma GenAI Platform (hoje renomeada para DigitalOcean Inference), ancorada no DigitalOcean GenAI Inference Engine e no Serverless Inference.
Neste guia prático, analiso a arquitetura do ecossistema de IA da DigitalOcean, o funcionamento do Inference Router (alimentado pelo proxy inteligente Plano), como integrar chamadas com o SDK compatível com OpenAI e como estruturar pipelines de inferência resilientes sem manter GPUs ociosas na fatura.
1. O Dilema da Infraestrutura de IA: Instâncias Dedicadas vs. Inferência Serverless#
Quando precisei desenhar a sustentação de agentes de IA e pipelines de RAG para os meus projetos, encontrei três opções clássicas de mercado, cada uma com seus gargalos:
- APIs Proprietárias Diretas (OpenAI / Anthropic): Fáceis de consumir via HTTP, mas sujeitas a aumentos de preços por token, restrições rígidas de rate-limit e aprisionamento tecnológico (vendor lock-in).
- GPUs Dedicadas Auto-Hospedadas (vLLM / Ollama em VPS com GPU): Oferecem controle total dos pesos dos modelos de código aberto (Llama 3, DeepSeek, Mistral), mas custam caro 24 horas por dia, exigem orquestração complexa de CUDA/drivers e não escalam para zero.
- Plataformas de Inferência Serverless: Você paga estritamente pelos tokens processados ou pelas frações de segundo de computação ativa. Quando não há requisições, o custo de hardware é exatamente zero.
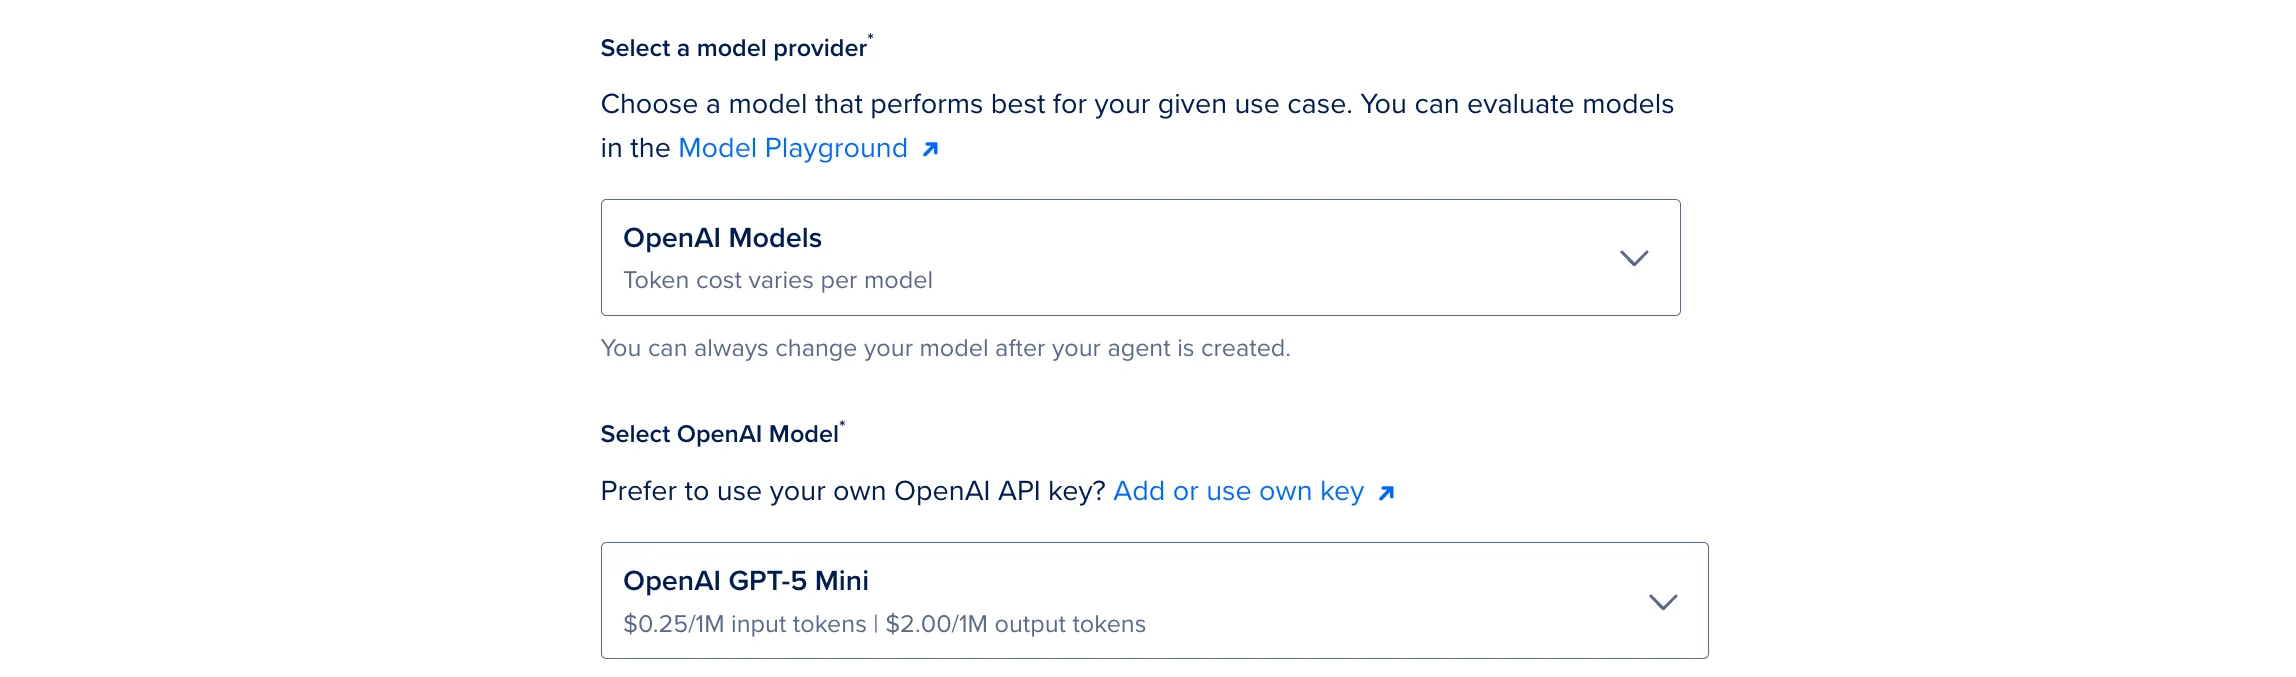
A proposta do DigitalOcean Serverless Inference é unir o melhor dos dois mundos: modelos abertos de ponta (o catálogo atual traz Llama 4 Maverick, DeepSeek V3 e a família Mistral, entre mais de 70 modelos) servidos sobre infraestrutura elástica de alta densidade, acessíveis por uma API padronizada e com faturamento baseado puramente no uso real.
2. A Arquitetura do DigitalOcean GenAI Platform: Control Plane e Data Plane#
O ecossistema GenAI da DigitalOcean separa de forma limpa o plano de controle administrativo do plano de execução dos dados:
┌─────────────────────────────────────────────────────────────┐
│                 Aplicações & Agentes (Clientes)            │
│          (Web Apps, Bots de Atendimento, Automações)        │
└──────────────────────────────┬──────────────────────────────┘
                               │ OpenAI-Compatible API
                               ▼
┌─────────────────────────────────────────────────────────────┐
│             DigitalOcean Inference Router (Plano)           │
│  - Intent Resolution (~200ms)                               │
│  - Políticas: Custo vs. Latência vs. Qualidade              │
│  - Fallback Automático em Falhas de Provedor                │
└──────────────┬───────────────────────────────┬──────────────┘
               │                               │
               ▼                               ▼
┌──────────────────────────────┐ ┌────────────────────────────┐
│    Serverless Inference      │ │    Dedicated Inference     │
│  - Meta Llama 3 / DeepSeek   │ │  - Clusters Privados GPU   │
│  - Modelos Open-Source       │ │  - Modelos Customizados    │
│  - Pagamento por Token       │ │  - Throughput Garantido    │
└──────────────────────────────┘ └────────────────────────────┘
O que compõe cada camada:#
- Control Plane (Plano de Controle): Gerencia workspaces, chaves de autenticação com escopos restritos (
genai:read,genai:create), orçamentos e catálogos de modelos. - Inference Engine (Data Plane): A camada de computação que executa os modelos. Suporta inferência serverless em tempo real, Dedicated Inference (GPUs dedicadas para cargas de alto volume) e processamento em lote (Batch Inference).
- Agent & RAG Platform: Módulo nativo que permite conectar bases de conhecimento estruturadas (documentos PDF, CSV, páginas web via crawler automático) para enriquecer o contexto dos prompts antes da chamada do modelo.
3. O Segredo do Roteamento Inteligente: Inference Router#
O Inference Router, hoje em public preview, roda sobre o Plano, proxy open-source criado na Katanemo — empresa adquirida pela DigitalOcean em abril de 2026. A própria DigitalOcean descreve a arquitetura e o modelo que resolve a intenção de cada chamada em cerca de 200 ms.
Em vez de codificar regras condicionais frágeis no seu código backend (ex: if prompt > 2000 tokens then use_model_B()), você aponta a sua aplicação para um único endpoint virtual.
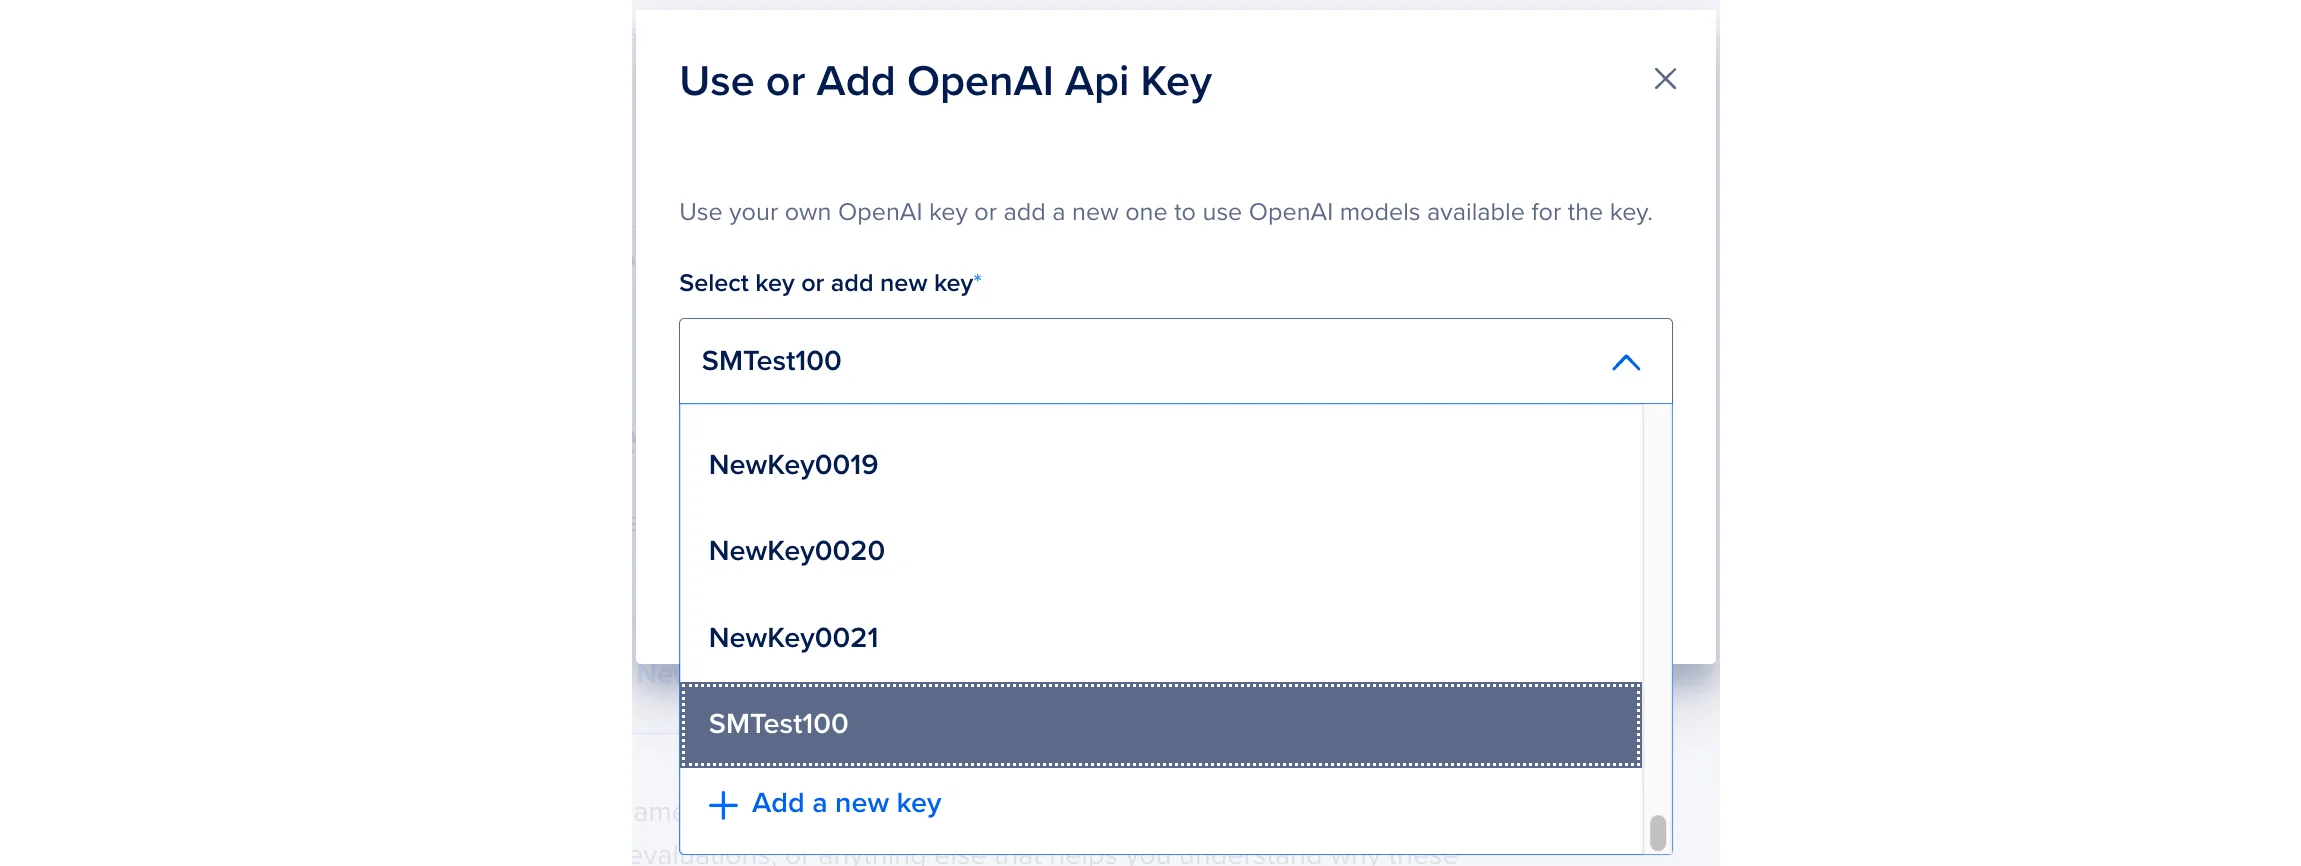
O Inference Router atua como um proxy reverso inteligente na borda:
- Resolução de Intenção Rápida (~200ms): Um modelo denso especializado avalia o contexto do prompt e a complexidade da instrução.
- Políticas de Otimização: Você define se a prioridade do roteador é Menor Custo, Menor Latência ou Maior Qualidade de Resposta. Tarefas simples de classificação são direcionadas para modelos mais leves e baratos (ex: Llama 3 8B), enquanto raciocínio complexo é encaminhado para modelos maiores.
- Mecanismo de Fallback Ordenado: Se o modelo principal sofrer degradação temporária ou atingir um pico de concorrência, o roteador redireciona a chamada automaticamente para o modelo secundário sem quebrar a requisição do usuário.
3.1 O que mudou em 2026: Plano-Orchestrator, presets e a aquisição da Katanemo#
A versão que está no ar não é mais um proxy genérico com regras: o roteamento é feito pelo Plano-Orchestrator, modelo treinado especificamente para detectar a tarefa da conversa. Ele vem em duas variantes — 4B densa, para implantações sensíveis a latência, e 30B-A3B (Mixture-of-Experts), para maior acurácia. Na avaliação publicada pela DigitalOcean com 1.958 mensagens em 605 conversas multi-turn, o 30B-A3B marcou 87,84% de acurácia média, à frente do GPT-5.1 (86,93%) e do Claude Sonnet 4.5 (86,11%).
Na prática, você não configura modelo por caso: escolhe um preset (Software Engineering, General, Writing ou Knowledge Base & Document Intelligence) ou monta um router próprio via API, define a política — Optimal, Cost Efficiency ou Speed Optimization — e aponta a aplicação para router:<nome>. A resposta informa qual modelo atendeu e qual tarefa foi identificada (cabeçalho x-model-router-selected-route); se nada casar, entram os fallbacks na ordem configurada.
4. Integração Prática: Consumindo a API via Python e cURL#
A DigitalOcean adotou compatibilidade total com a especificação de chat completion da OpenAI. Isso significa que você não precisa reescrever sua base de código: basta alterar a base_url e o token de autorização.
Exemplo 1: Chamada Direta via cURL no Terminal Linux#
curl -X POST "https://inference.do-ai.run/v1/chat/completions" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DO_GENAI_API_KEY" \
  -d '{
    "model": "llama-4-maverick",
    "messages": [
      {
        "role": "system",
        "content": "Você é um especialista em sustentação Linux e arquitetura de servidores."
      },
      {
        "role": "user",
        "content": "Quais parâmetros do sysctl otimizam o buffer de rede em um servidor web com alto tráfego?"
      }
    ],
    "temperature": 0.3,
    "max_tokens": 512
  }'
Exemplo 2: Integração com SDK Oficial da OpenAI em Python#
import os
from openai import OpenAI

# Inicializa o cliente apontando para o endpoint da DigitalOcean
client = OpenAI(
    base_url="https://inference.do-ai.run/v1",
    api_key=os.environ.get("DO_GENAI_API_KEY")
)

response = client.chat.completions.create(
    model="router:software-engineering",
    messages=[
        {"role": "system", "content": "Assistente de diagnóstico de infraestrutura."},
        {"role": "user", "content": "Analise o log: nginx 502 Bad Gateway - connect() to php-fpm.sock failed (11: Resource temporarily unavailable)"}
    ],
    temperature=0.2,
)

print(response.choices[0].message.content)
Observe que na chamada Python acima o parâmetro model aponta para um preset de roteador: o proxy da DigitalOcean escolhe o modelo final aplicando a política configurada — custo, latência ou qualidade — sem que a aplicação saiba qual endpoint atendeu a requisição.
5. Comparativo Econômico: GPU Dedicada vs. DigitalOcean Serverless Inference#
Para entender o impacto no orçamento de infraestrutura, montei um cenário comparativo real baseado no perfil de uso de uma startup ou software SaaS em crescimento:
| Métrica Operacional | Dedicated Inference (1× AMD MI300X) | DigitalOcean Serverless Inference |
|---|---|---|
| Custo Base Mensal (Parado) | ~US$ 1.890 / mês (US$ 2,59/hora × 730 h) | US$ 0,00 |
| Carga de Trabalho (Horário Comercial) | 8 horas/dia ativas | Paga apenas pelos tokens processados |
| Custo de Noites e Finais de Semana | Continua cobrando 100% | Zero cobrança |
| Manutenção de Drivers & CUDA | Manual (Sysadmin cuida de updates e falhas) | 100% gerenciado pela nuvem |
| Tolerância a Picos Repentinos | Travamento com erro de Out of Memory (OOM) | Auto-scaling elástico imediato |
| Roteamento Multi-Modelo | Limitado à VRAM física da placa instalada | Acesso instantâneo a dezenas de LLMs |
No cenário da tabela, em que a GPU só trabalha em horário comercial, cerca de três quartos das horas do mês ficam ociosos — e é essa fração da fatura que a cobrança por token elimina. Na direção oposta, se o volume mantém a GPU ocupada quase o tempo todo, o endpoint dedicado cobrado por hora tende a sair mais barato que o token.
5.1 O que a fatura de inferência cobra de fato#
Vale separar as quatro linhas de cobrança, porque elas respondem de formas diferentes ao mesmo tráfego:
- Serverless Inference: tarifa por 1 milhão de tokens, publicada por modelo, cobrada de forma pré-paga — sem requisição, sem cobrança.
- Dedicated Inference: por GPU-hora, independentemente de haver tráfego. Na tabela oficial: AMD MI300X US$ 2,59/h; MI325X US$ 2,98/h; NVIDIA H100 US$ 4,41/h; H200 US$ 4,47/h; B300 US$ 10,39/h (conjuntos multi-GPU têm preço próprio, como 8× MI300X a US$ 20,70/h).
- Batch Inference: até 50% de desconto sobre as tarifas de modelos OpenAI e Anthropic, cobrando apenas requisições concluídas.
- Inference Router: sem custo adicional durante o public preview; você paga apenas pelos tokens do modelo que atendeu a chamada.
É a diferença entre alugar a placa e alugar o resultado. Para tráfego intermitente, a segunda coluna ganha; para fluxo contínuo e previsível, a GPU dedicada ainda pode ser mais barata por token — e agora dá para comparar as duas na mesma fatura.
6. Governança de Segurança e Boas Práticas#
Ao lidar com inteligência artificial generativa em ambientes corporativos, a segurança dos dados e o controle de acesso são prioritários:
- Tokens com Menor Privilégio: Crie tokens de API dedicados exclusivamente para inferência (
dedicated_inferenceou escopo de leitura serverless), evitando usar o token mestre com privilégios de destruição de Droplets ou volumes. - Isolamento de Dados no RAG: Segundo a política de privacidade da Inference, a DigitalOcean não usa prompts nem documentos enviados para treinar, retreinar ou ajustar modelos generalizados. As exceções ficam por conta do Signals (recurso opcional de trace) e de modelos de terceiros, que seguem a retenção do provedor original.
- Observabilidade e Limites de Consumo: Configure alertas de orçamento (billing alerts) no painel da DigitalOcean para acompanhar o consumo acumulado de tokens e evitar surpresas no fechamento do ciclo.
7. Veredito do Sysadmin: Quando Migrar para a DigitalOcean Inference?#
Vale a pena migrar se:#
- Sua aplicação utiliza modelos abertos (Llama, DeepSeek, Mistral) e você quer eliminar custos de instâncias de GPU ociosas.
- Seu sistema sofre com tráfego irregular (picos durante o dia e baixa demanda durante a noite).
- Você quer simplificar sua pilha técnica consumindo uma API única compatível com o padrão de mercado sem configurar clusters Kubernetes pesados.
- Você precisa de roteamento automático com redundância entre modelos para garantir alta disponibilidade.
7.1 Checklist de migração#
- Meça primeiro: exporte o consumo de tokens por dia ou semana do provedor atual (ou estime pelo log de requisições). Sem esse número, qualquer comparação é chute.
- Teste o preset antes do código: rode um router de preset no Playground e compare custo e latência por requisição com o modelo único que você usa hoje.
- Coloque crédito pré-pago: a inferência serverless é pré-paga; sem saldo ou créditos, as requisições são suspensas.
- Defina a política por rota: custo para classificação e resumo, qualidade para raciocínio, latência para atendimento em tempo real.
- Só então considere o dedicado: se a GPU ficar ocupada na maior parte do mês, o endpoint por hora (US$ 2,59/h na MI300X) entra na conta como alternativa, não como padrão.
Quem quiser testar a infraestrutura e criar os primeiros endpoints de inferência serverless pode explorar a plataforma diretamente na DigitalOcean.
8. Perguntas Frequentes (FAQ)#
Posso utilizar o SDK da OpenAI sem alterar minha lógica de negócio?#
Sim. Como a API da DigitalOcean implementa a especificação oficial de Chat Completions, basta configurar o parâmetro base_url para https://inference.do-ai.run/v1 e informar sua model access key nos SDKs oficiais de Python, Node.js, Go ou PHP.
Os meus dados enviados nos prompts são usados para treinar os modelos da DigitalOcean?#
Não. A documentação de privacidade da Inference afirma que a DigitalOcean não usa o conteúdo do cliente para treinar modelos generalizados e não o envia de volta ao criador do modelo. A ressalva fica para modelos de terceiros conectados por você e para o Signals (opcional), que obedecem às políticas de retenção do provedor.
Qual é a diferença entre Serverless Inference e Dedicated Inference?#
No Serverless Inference, você compartilha a infraestrutura elástica e paga estritamente pelo volume de tokens consumidos, com auto-scaling automático até zero. Na Dedicated Inference, você reserva GPUs exclusivas para sua organização, com throughput previsível e isolamento de hardware para aplicações corporativas com fluxo contínuo de alta demanda.
Este artigo foi útil?
Deixe uma reação rápida para apoiar o conteúdo:
Veja também

Este post está licenciado sob CC BY-NC.
Comentários
Participe da discussão abaixo.
0 comentários