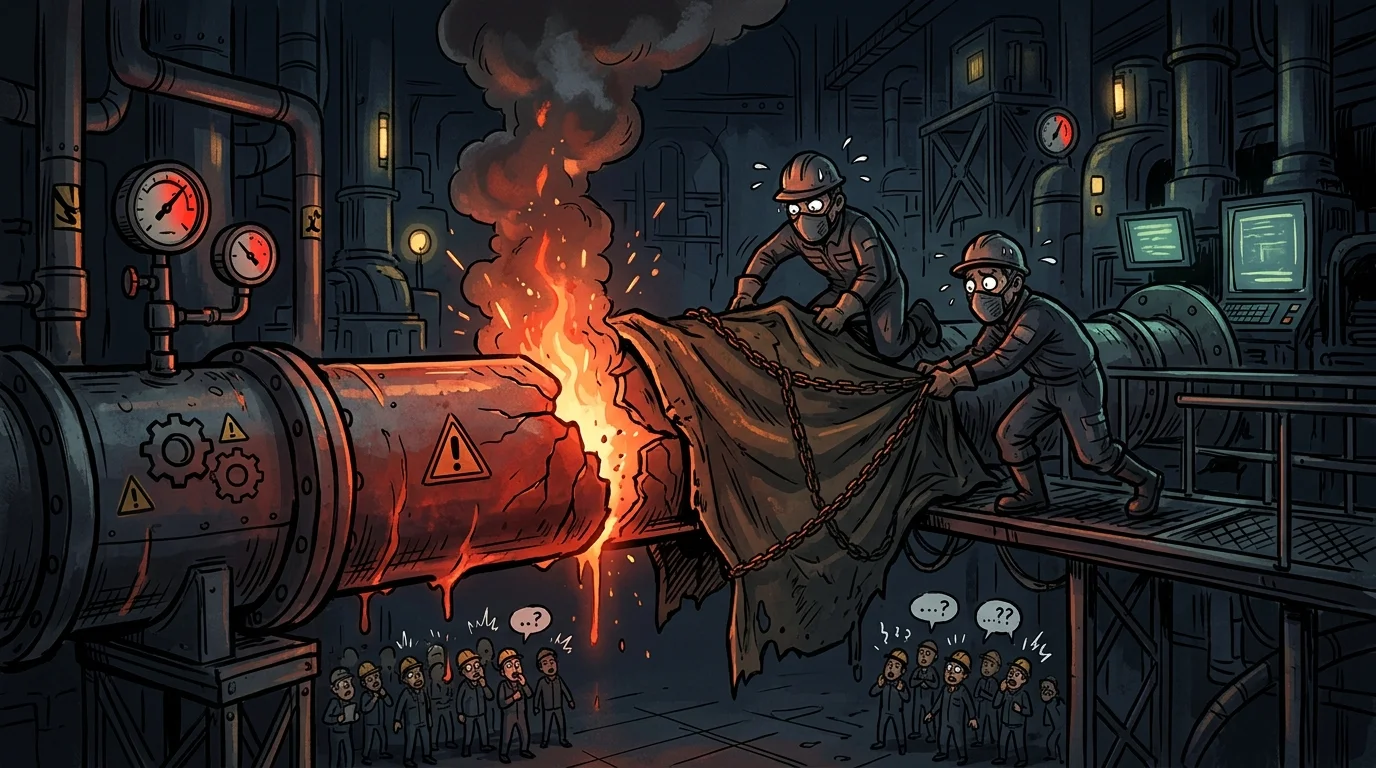
No ecossistema de infraestrutura e serviços digitais, há um princípio que a prática insiste em comprovar: na ausência de dados oficiais, a mente humana preenche o vazio com o pior cenário possível.
Em uma experiência marcante na minha trajetória acompanhando operações e serviços digitais, testemunhei de perto uma decisão executiva que desafiou o bom senso operacional. Por receio de expor instabilidades ou desgastar a marca, a diretoria impôs uma barreira imediata: suspendeu comunicações preventivas sobre manutenções, silenciou alertas durante incidentes críticos, aboliu notas de atualização de produtos e cortou disparos de e-mail aos usuários.
O raciocínio implícito era a clássica falácia do avestruz: "se não notificarmos o cliente, talvez ele ache que a lentidão é local e não seremos cobrados".
A realidade operacional, no entanto, cobrou o preço exato em métricas, estresse de equipe e evasão de receita. A postura só recuou após forte confronto técnico da gerência, armada com relatórios de volume de fila, degradação de SLA e cancelamentos.
A psicologia do vácuo: por que o silêncio multiplica o pânico#
O erro de suprimir alertas não é apenas uma falha de relações públicas; é uma violação direta de como o cérebro humano processa riscos e incertezas.
Aversão à ambiguidade e teoria dos prospectos#
Desenvolvida pelos psicólogos Daniel Kahneman e Amos Tversky, a pesquisa em economia comportamental demonstra que a incerteza absoluta gera mais aversão e resposta emocional negativa do que uma perda concreta conhecida.
Um usuário que recebe o aviso "estamos com degradação de 30% e previsão de volta às 16h" consegue recalcular suas ações, reorganizar compromissos e avisar sua própria equipe. Já um usuário diante de uma tela em branco sem retorno presume perda irrecuperável de dados ou falência do provedor.
Intolerância à incerteza#
Na psicologia comportamental (estudos de Freeston, Dugas et al.), a ausência de retorno estimula a ruminação catastrófica. O cliente não espera pacientemente; ele entra em estado de urgência, reinicia suas conexões repetidamente, tenta acessos simultâneos e inunda os canais de contato com pedidos de socorro.
A anatomia do desastre em métricas operacionais#
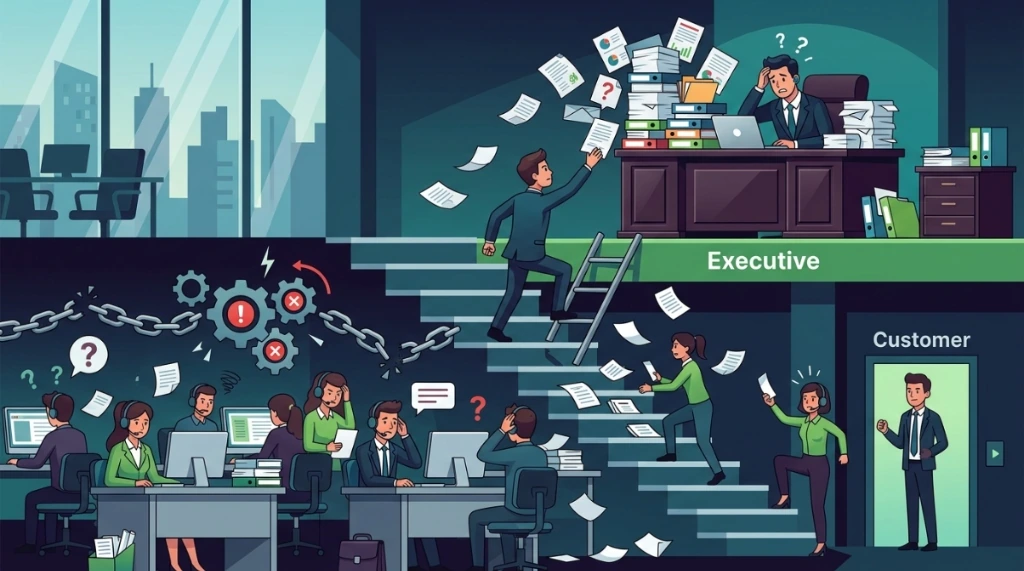
O silêncio corporativo não diminui a crise; ele a transfere inteira para o custo operacional e a exaustão da linha de frente. Quando uma liderança corta o contato direto (e-mail, status page, avisos no painel), os indicadores operacionais reagem de forma imediata:
| Métrica operacional | Com comunicação proativa | Com política de silêncio / ocultação |
|---|---|---|
| Volume de tickets recebidos | Aumento contido de 15% a 25% | Explosão de 300% a 500% (tickets repetidos pelo mesmo usuário) |
| Tempo médio de atendimento (TMA) | Estável (resposta padrão e direcionada) | Aumento de até 80% (agente gasta tempo acalmando o cliente irritado) |
| CSAT / NPS de resolução | Queda leve de 5% a 10% | Queda abrupta de 40% a 60% |
| Taxa de retenção pós-incidente | Preservada (transparência gera fidelidade) | Churn direto acelerado nos 30 dias subsequentes |
Um levantamento clássico da Gartner sobre gestão de incidentes aponta que até 60% dos chamados abertos durante um downtime severo são redundantes. Em termos práticos, são usuários apenas perguntando se a empresa já sabe que o serviço caiu.
Quando o canal de saída é cortado, essa carga inteira cai sobre os atendentes de suporte, que acabam gastando capacidade computacional e humana gerando respostas reativas em vez de focar na resolução da pane. Eu já mostrei em detalhes por que sua empresa precisa de um canal de status para interromper esse ciclo de tickets repetidos.
Casos reais: como grandes empresas respondem à falha#
O contraste entre empresas que sobrevivem a incidentes e as que perdem tração de mercado está na postura durante a disrupção.
Quem transformou transparência em autoridade#
- Cloudflare: Durante suas falhas globais mais severas (como incidentes de BGP e a pane de regex do WAF em 2019), a empresa adotou o padrão de publicar relatórios técnicos exaustivos poucas horas após o restabelecimento. Eles detalham commits, configurações de roteamento e medidas tomadas. Em vez de fuga em massa de clientes, conquistaram respeito técnico global.
- AWS e GitHub: Mantêm painéis de telemetria em tempo real com histórico transparente. Incidentes com logs detalhados provam aos clientes corporativos que a operação possui observabilidade e governança sob conformidades rígidas (como SOC 2 e ISO 27001).
Quem escolheu ocultar e pagou a conta#
- DigiNotar (2011): A autoridade certificadora holandesa foi invadida e sofreu emissão de certificados fraudulentos. Em vez de notificar os clientes, o consórcio do setor e os desenvolvedores de navegadores imediatamente, escondeu a brecha por semanas na tentativa de resolver o caso em segredo. Quando a história veio a público por fontes externas, os navegadores revogaram o certificado raiz da DigiNotar em bloco. Sem confiança do mercado, a empresa faliu em questão de semanas.
- Uber (2016): A liderança tentou acobertar uma exfiltração de dados de 57 milhões de usuários e motoristas, pagando os invasores sob o disfarce de recompensa de bug (bug bounty) com termos de sigilo, sem avisar os órgãos reguladores. A ocultação gerou multas superiores a US$ 148 milhões, processos criminais contra gestores da época e desgaste irreparável na reputação da marca.
- Equifax (2017): Ao descobrir uma brecha em decorrência de uma falha não corrigida no Apache Struts, a liderança levou mais de seis semanas para vir a público. O silêncio e as comunicações desencontradas custaram mais de US$ 1 bilhão em acordos judiciais, renúncia de executivos e danos crônicos ao valor de mercado.
O papel inegociável da governança#
Quando a equipe técnica insiste em reverter ordens de silêncio e restabelecer os canais de comunicação, não se trata de uma disputa de ego interno. Trata-se de defender a viabilidade comercial do negócio.
Problemas de rede, falhas de hardware, picos de tráfego e bugs de software acontecem em qualquer sistema do mundo real. Clientes compreendem a falha técnica eventual. O que destrói contratos não é o servidor que oscilou por duas horas; é descobrir que a empresa preferiu deixá-los operando no escuro.
Abaixo, reuni os templates e documentos práticos que aplico para manter alinhamento em momentos de crise, cobrindo avisos em tempo real, relatórios de causa-raiz e a régua de comunicação contratual.
Modelos de atualização em tempo real#
Durante a contenção, mensagens curtas e previsíveis evitam sobrecarga de chamados. O segredo é sempre informar o estado atual, o impacto real e o momento do próximo retorno, mesmo que a causa-raiz ainda esteja sob diagnóstico.
Alerta inicial (investigação)#
Assunto / Título: [Investigando] Instabilidade identificada no serviço [Nome do Serviço/API]

Status: Investigação em andamento
Impacto: Clientes podem notar lentidão ou erros [ex: HTTP 500 / timeouts] ao acessar [Funcionalidade/Painel].
Ação atual: Nosso time já identificou a anomalia e está analisando os logs e telemetria para isolar a causa.
Próxima atualização: Em até 20 minutos (às [HH:MM]) ou assim que houver novidades concretas.
Alerta intermediário (identificação e mitigação)#
Assunto / Título: [Identificado] Mitigação em andamento para [Nome do Serviço]

Status: Em mitigação / Correção em aplicação
Impacto: [Funcionalidade específica] segue inacessível para cerca de [X%] dos usuários. Outros módulos operam normalmente.
Causa identificada: Foi constatada uma sobrecarga em [ex: banco de dados / fila de mensagens / cluster X] após [evento gatilho, se confirmado].
Ação em andamento: Estamos executando [ex: failover para réplica / rollback da versão Y / drenagem de conexões] para restabelecer a estabilidade.
Próxima atualização: Em até 30 minutos (às [HH:MM]).
Alerta de restabelecimento (monitoramento)#
Assunto / Título: [Monitoramento] Serviços restabelecidos para [Nome do Serviço]

Status: Monitoramento ativo
Impacto: Tráfego e acessos normalizados desde as [HH:MM].
Ação executada: O procedimento de [ex: rollback / reinicialização e rebalanceamento] estabilizou as taxas de erro e latência para os limites normais.
Status: O sistema está sob observação contínua. Publicaremos o relatório preliminar de encerramento em até [X] horas.
Modelo estruturado de post-mortem blameless#
Este documento deve ser preenchido após a estabilização do ambiente. Ele segue a filosofia blameless (sem apontar culpados individuais), concentrando o foco em falhas de processo, automação e arquitetura.
# [Post-Mortem] Incidente: [Título curto e descritivo do incidente]

**Data do incidente:** YYYY-MM-DD
**Status do documento:** [Rascunho / Em revisão / Aprovado / Publicado ao cliente]
**Classificação de severidade:** [SEV-1 (Crítico) / SEV-2 (Alto) / SEV-3 (Médio)]
**Responsável pelo incidente:** [Nome/Papel]
**Líder técnico de resolução:** [Nome/Papel]
**Redator do documento:** [Nome/Papel]

---

## 1. Resumo executivo
Resumo direto, compreensível tanto por times técnicos quanto por clientes de negócios.
* **O que aconteceu:** Descrição direta do evento técnico.
* **Impacto no cliente:** Volume de usuários atingidos, perda de funcionalidade, duração e dados sobre operações afetadas.
* **Como foi resolvido:** A intervenção definitiva aplicada.

---

## 2. Métricas de impacto
* **Início do incidente:** YYYY-MM-DD HH:MM [Fuso Horário]
* **Detecção:** YYYY-MM-DD HH:MM
* **Início da mitigação:** YYYY-MM-DD HH:MM
* **Resolução completa:** YYYY-MM-DD HH:MM
* **Tempo total de degradação:** X horas e Y minutos
* **TTD (Time to Detect):** X min (alerta automático ou reporte de cliente?)
* **TTR (Time to Resolve):** Y min
* **Contas atingidas:** ~X% da base ativa (ou N contas)
* **Tickets de suporte abertos:** N chamados correlacionados

---

## 3. Linha do tempo detalhada
Cronologia em ordem crescente com horários precisos extraídos de logs e canais de resposta.

* **HH:MM** - Ocorre o evento gatilho (ex: deploy da versão v2.4.1 ou pico de conexões).
* **HH:MM** - Primeiro alerta disparado no canal de monitoramento (ex: latência p99 acima de 3s).
* **HH:MM** - Primeiro cliente abre chamado via suporte reportando timeout.
* **HH:MM** - Abertura da sala de crise e declaração de SEV-1.
* **HH:MM** - Primeira atualização enviada aos clientes via painel de status.
* **HH:MM** - Hipótese A (falha de rede externa) é descartada após checagem de roteamento.
* **HH:MM** - Causa identificada no esgotamento do pool de conexões com o banco de dados.
* **HH:MM** - Ação de mitigação aplicada (reinicialização do pool e reversão da migração).
* **HH:MM** - Latência e taxas de erro HTTP 5xx retornam ao baseline operacional.
* **HH:MM** - Comunicado final de resolução publicado.

---

## 4. Análise de causa-raiz (método dos 5 porquês)
Investigação estruturada para encontrar a falha sistêmica, não o erro individual.

1. **Por que o serviço ficou indisponível?**
   Porque o pool de conexões com o banco de dados principal foi esgotado, recusando novas requisições.
2. **Por que o pool foi esgotado?**
   Uma nova consulta adicionada na última release não possuía índice adequado e realizava varredura completa na tabela (*full table scan*).
3. **Por que a consulta lenta causou indisponibilidade geral?**
   As conexões ficavam presas aguardando leitura de disco por até 30 segundos, sem timeout agressivo configurado na aplicação.
4. **Por que a consulta sem índice chegou a produção?**
   O ambiente de testes possuía um volume de dados reduzido (1.000 linhas contra 15 milhões em produção), mascarando a lentidão nos testes prévios.
5. **Por que o pipeline de entrega contínua não detectou a falta de índice?**
   Não havia etapa de validação estática de migrações nem teste de carga automatizado antes da publicação.

---

## 5. O que funcionou bem vs. o que falhou

### O que funcionou bem
* Os alertas de latência p99 dispararam em menos de 2 minutos após o início da degradação.
* A comunicação para os clientes foi enviada em 12 minutos, contendo o fluxo de tickets.
* O processo de reversão (*rollback*) funcionou conforme o roteiro previsto.

### O que precisa de melhoria
* A triagem inicial perdeu 15 minutos investigando supostas anomalias de rede.
* O painel de métricas do banco de dados não estava acessível para os analistas em plantão.
* Ausência de proteção contra sobrecarga (*circuit breaker*) na rota afetada.

---

## 6. Plano de ação preventivo
Toda análise pós-incidente deve resultar em tarefas com prazo, responsável e identificador rastreável. Sem isso, a mesma falha volta a ocorrer.

| Ação preventiva | Tipo | Responsável | Prazo | Ticket / ID |
| :--- | :--- | :--- | :--- | :--- |
| Adicionar timeout de 3s em todas as conexões de banco | Mitigação | @dev-backend | D+3 | `TICK-1021` |
| Implementar linter de SQL no pipeline de CI | Prevenção | @devops | D+7 | `TICK-1022` |
| Criar banco de homologação com dados reais higienizados | Prevenção | @infra | D+15 | `TICK-1023` |
| Adicionar métricas de pool no dashboard central | Detecção | @sre | D+5 | `TICK-1024` |
Régua de comunicação B2B para risco e quebra de SLA#
Em relações corporativas, a velocidade da notificação define se a conversa após o incidente será técnica ou jurídica. Esta régua padroniza o fluxo:
| Fase | Gatilho / Momento | Canal recomendado | Responsável pelo envio |
|---|---|---|---|
| Fase 1: Alerta proativo | Incidente crítico aberto há mais de 30 min (risco de violar SLA) | E-mail formal com cópia ao gestor da conta | Suporte técnico / Coordenador do incidente |
| Fase 2: Notificação de quebra | Downtime ultrapassa o limiar contratual acordado | E-mail formal com cópia para gerência | Direção de operações / Atendimento |
| Fase 3: Relatório pós-incidente | 24h a 48h úteis após a normalização | E-mail com relatório de causa-raiz em anexo | Gestor da conta + Líder técnico |
| Fase 4: Acerto de crédito | Ciclo de faturamento ou até D+5 da apuração | Notificação formal do financeiro | Operações financeiras / Faturamento |
Modelo 1: alerta de risco iminente de SLA (Fase 1)#
Assunto: [Aviso operacional] Notificação de incidente em andamento e monitoramento de SLA – [Sua Empresa]
Para: [Contato do Cliente]
Cc: [Gestor da Conta]

Prezado(a) [Nome do Gestor],

Informamos que identificamos, às [HH:MM], uma instabilidade técnica que afeta o serviço [Nome do Serviço], impactando [descrever escopo: ex: autenticação e processamento de pedidos].

O incidente foi classificado como prioridade crítica e está sob tratamento contínuo de nossa equipe técnica.

Em atenção aos termos de transparência do contrato firmado entre nossas empresas, notificamos que há risco de aproximação do limite de tolerância de SLA estipulado para este ciclo ([ex: 99,9% / janela máxima de X horas]).

Status atual das ações:
* Causa provável sob contenção: [Breve linha técnica, ex: isolamento de tráfego anômalo / failover de cluster].
* Próxima janela de atualização formal: até as [HH:MM] ou imediatamente mediante fato novo.

Nosso canal prioritário permanece aberto para o seu time via chamado #[Número].

Atenciosamente,
[Seu Nome]
[Seu Papel / Cargo]
[Sua Empresa]
Modelo 2: notificação formal de violação de SLA (Fase 2)#
Assunto: [Notificação formal] Apuração de impacto operacional e violação de SLA – [ID do Incidente]
Para: [Diretoria Técnica do Cliente]
Cc: [Gestor da Conta / Jurídico Interno]

Prezado(a) [Nome do Gestor],

Apresentamos nossa posição oficial referente à instabilidade que afetou o ambiente da [Nome do Cliente] no dia [DD/MM/AAAA], entre [HH:MM] e [HH:MM].

Reconhecemos formalmente que o tempo total de indisponibilidade superou os limites acordados na Cláusula de SLA, caracterizando violação dos níveis de serviço contratados para o período.

Os serviços foram integralmente normalizados às [HH:MM], após [resumo da ação corretiva definitiva: ex: reconstrução de rotas e aplicação de patch de correção].

Compreendemos o impacto que interrupções dessa natureza provocam na sua rotina. O relatório técnico detalhado (RCA) está em fase final de consolidação e será compartilhado formalmente até [Data/Hora – prazo máximo de 48h].

Atenciosamente,
[Nome do Responsável]
[Direção de Operações / Tecnologia]
[Sua Empresa]
Modelo 3: envio de relatório e plano preventivo (Fase 3)#
Assunto: [Relatório técnico concluído] Análise de causa-raiz e ações corretivas – Ref: [ID do Incidente]
Para: [Gestor do Cliente]
Cc: [Gestor da Conta]

Prezado(a) [Nome do Gestor],

Em continuidade à notificação enviada em [Data anterior], disponibilizamos em anexo o documento oficial de análise de causa-raiz relativo ao evento do dia [Data do evento].

Resumo dos pontos centrais apurados:
* Causa-raiz: [Resumo claro sobre o gatilho sistêmico que falhou].
* Tempo total de impacto: [X horas e Y minutos].
* Medida imediata: [Ação que conteve o incidente].

Plano preventivo em execução:
Para evitar que este cenário se repita, definimos as seguintes medidas estruturais, já sob acompanhamento em nosso cronograma:
1. [Ação 1 - ex: Redundância multi-região na camada de dados];
2. [Ação 2 - ex: Automação de testes de estresse em esteira de CI/CD];
3. [Ação 3 - ex: Revisão e redução de timeouts de failover automático para menos de 60s].

Estamos à disposição para uma conferência técnica de alinhamento com sua equipe caso desejem aprofundar qualquer ponto do relatório.

Atenciosamente,
[Seu Nome]
[Cargo / Responsável pelo Atendimento]
[Sua Empresa]
Modelo 4: aplicação de crédito de serviço (Fase 4)#
Assunto: [Crédito de serviço] Apuração financeira e aplicação de penalidade contratual – Contrato [Número]
Para: [Gestor Financeiro do Cliente]
Cc: [Gestor do Contrato]

Prezado(a) [Nome do Responsável],

Em decorrência do incidente técnico apurado em [Data do incidente] (Chamado #[Número]), apuramos a métrica de disponibilidade mensal referente à fatura do ciclo [Mês/Ano].

Conforme estipulado no anexo de SLA do nosso contrato:
* SLA contratado: [ex: 99,90% de uptime]
* Uptime registrado no período: [ex: 98,45%]
* Compensação devida: [ex: Crédito de 15% sobre o valor da mensalidade (MRR)]
* Valor do crédito: [R$ X.XXX,XX]

O desconto será aplicado diretamente na fatura com vencimento em [Data da Próxima Fatura] sob a descrição: "Crédito de Nível de Serviço (SLA Breach) - Incidente [ID]".

Permanecemos à disposição para esclarecimentos adicionais.

Atenciosamente,
[Nome do Responsável]
[Faturamento e Controladoria]
[Sua Empresa]
Minuta de SLA e política contratual de créditos#
Para que essas comunicações tenham valor jurídico e protejam ambas as partes de desgastes subjetivos, o contrato precisa de um anexo técnico claro. Esta minuta equilibra as garantias do cliente com proteções operacionais contra fatores externos fora de alcance.
ANEXO [X] – ACORDO DE NÍVEL DE SERVIÇO (SLA) E POLÍTICA DE CRÉDITOS

Este Anexo é parte integrante e indissociável do Contrato Principal de Prestação de Serviços firmado entre as Partes.

CLÁUSULA 1ª – DEFINIÇÕES OPERACIONAIS

1.1. Disponibilidade Mensal: Percentual de tempo em que os Serviços contratados permaneceram acessíveis e operacionais em ambiente de produção durante determinado Mês Civil.
1.2. Indisponibilidade (Downtime): Período contínuo no qual o Serviço se encontra integralmente inacessível via Internet ou apresentando taxa de erro HTTP 5xx superior a 5% em requisições válidas, aferido pelas ferramentas de telemetria e monitoramento da CONTRATADA.
1.3. Manutenção Programada: Intervenções técnicas preventivas devidamente comunicadas ao CONTRATANTE com antecedência mínima de 5 (cinco) dias úteis e executadas preferencialmente na Janela Padrão (das 00:00h às 05:00h no fuso horário de Brasília).
1.4. Manutenção Emergencial: Intervenções críticas destinadas a sanar vulnerabilidades de dia-zero (zero-day) ou risco de colapso de infraestrutura, com comunicação prévia imediata ou em até 2 (duas) horas após o início dos trabalhos.

CLÁUSULA 2ª – NÍVEIS DE DISPONIBILIDADE CONTRATADOS

2.1. Meta de Disponibilidade: A CONTRATADA compromete-se a manter uma Disponibilidade Mensal mínima de 99,90% para os Serviços em ambiente de produção em cada Mês Civil.
2.2. Fórmula de Cálculo: A Disponibilidade Mensal será calculada com base na seguinte proporção:

Disponibilidade (%) = ((Minutos Totais do Mês - Minutos de Indisponibilidade Elegíveis) / Minutos Totais do Mês) * 100

Parágrafo Único: Em um mês de 30 dias (43.200 minutos), a margem máxima de Indisponibilidade Elegível para cumprimento da meta de 99,90% é de aproximadamente 43 minutos e 12 segundos.

CLÁUSULA 3ª – EXCLUSÕES DA INDISPONIBILIDADE (DOWNTIME NÃO ELEGÍVEL)

3.1. Não serão computados como Indisponibilidade para fins de quebra de SLA ou créditos:
a) Janelas de Manutenção Programada e Emergencial nos termos da Cláusula 1ª;
b) Falhas decorrentes de ações, omissões, scripts ou aplicações desenvolvidas pelo próprio CONTRATANTE ou por terceiros sob sua gestão;
c) Ataques cibernéticos distribuídos de negação de serviço (DDoS) que excedam expressamente a capacidade contratada de mitigação;
d) Eventos de caso fortuito ou força maior, nos termos do art. 393 do Código Civil Brasileiro;
e) Falhas em concessionárias de energia pública, operadoras de telecomunicações e rotas de trânsito global de Internet alheias à infraestrutura direta da CONTRATADA;
f) Bloqueio dos Serviços por inadimplemento financeiro do CONTRATANTE.

CLÁUSULA 4ª – TABELA DE CRÉDITOS DE SERVIÇO (SERVICE CREDITS)

4.1. Caso a CONTRATADA não atinja a meta estipulada na Cláusula 2ª em determinado Mês Civil, o CONTRATANTE fará jus a uma compensação sob a forma de Crédito de Serviço, calculada sobre a mensalidade fixa do mês afetado:

* Disponibilidade ≥ 99,90%: 0% (Meta cumprida)
* Disponibilidade de 99,00% a 99,89%: 10% de crédito
* Disponibilidade de 95,00% a 98,99%: 25% de crédito
* Disponibilidade < 95,00%: 50% de crédito

CLÁUSULA 5ª – PROCEDIMENTO DE SOLICITAÇÃO E APLICAÇÃO

5.1. Abertura: O CONTRATANTE deverá solicitar a apuração do crédito via chamado formal em até 15 (quinze) dias corridos após o fechamento do mês afetado.
5.2. Validação: A CONTRATADA analisará os registros de telemetria internos e responderá no prazo de até 10 (dez) dias úteis com o relatório consolidado de disponibilidade.
5.3. Compensação: O crédito concedido será abatido na fatura subsequente à apuração. Os Créditos de Serviço não são conversíveis em dinheiro ou transferências bancárias.
5.4. Teto Limite: O valor cumulado de Créditos de Serviço aplicáveis em um mesmo mês não ultrapassará, sob qualquer hipótese, o teto de 50% do valor da mensalidade daquele ciclo.

CLÁUSULA 6ª – CARÁTER INDENIZATÓRIO E RESCISÃO

6.1. Natureza Exclusiva: Os Créditos de Serviço previstos neste Anexo constituem a única compensação operacional e financeira devida pela CONTRATADA ao CONTRATANTE por falhas de disponibilidade acordadas.
6.2. Rescisão por Falha Recorrente: Caso a Disponibilidade Mensal permaneça abaixo de 95,00% por 2 (dois) meses consecutivos ou por 3 (três) meses intercalados no intervalo de 12 meses, assistirá ao CONTRATANTE o direito de rescindir o Contrato Principal por justa causa técnica, sem aplicação de aviso prévio ou multas rescisórias.
O valor prático da verdade operacional#
Ao longo dos anos lidando com sistemas que atendem milhares de pessoas todos os dias, aprendi que nenhum cliente espera perfeição mágica de hardware e software. O que o cliente procura é previsibilidade. Ele quer ter a certeza de que, quando algo quebrar, não será feito de bobo com mensagens vagas ou silêncio corporativo.
Apostar no sigilo durante incidentes é uma estratégia que cobra juros compostos: multiplica o desgaste dos atendentes, gera desconfiança permanente nos contratos e destrói o valor da marca no primeiro vazamento inevitável. Adotar transparência ativa, com canais de status visíveis, relatórios sem busca de culpados e réguas de SLA bem amarradas, transforma momentos de crise no maior atestado de maturidade que uma empresa pode oferecer.
Este artigo foi útil?
Deixe uma reação rápida para apoiar o conteúdo:
Veja também
Este post está licenciado sob CC BY-NC.
Comentários
Participe da discussão abaixo.
0 comentários