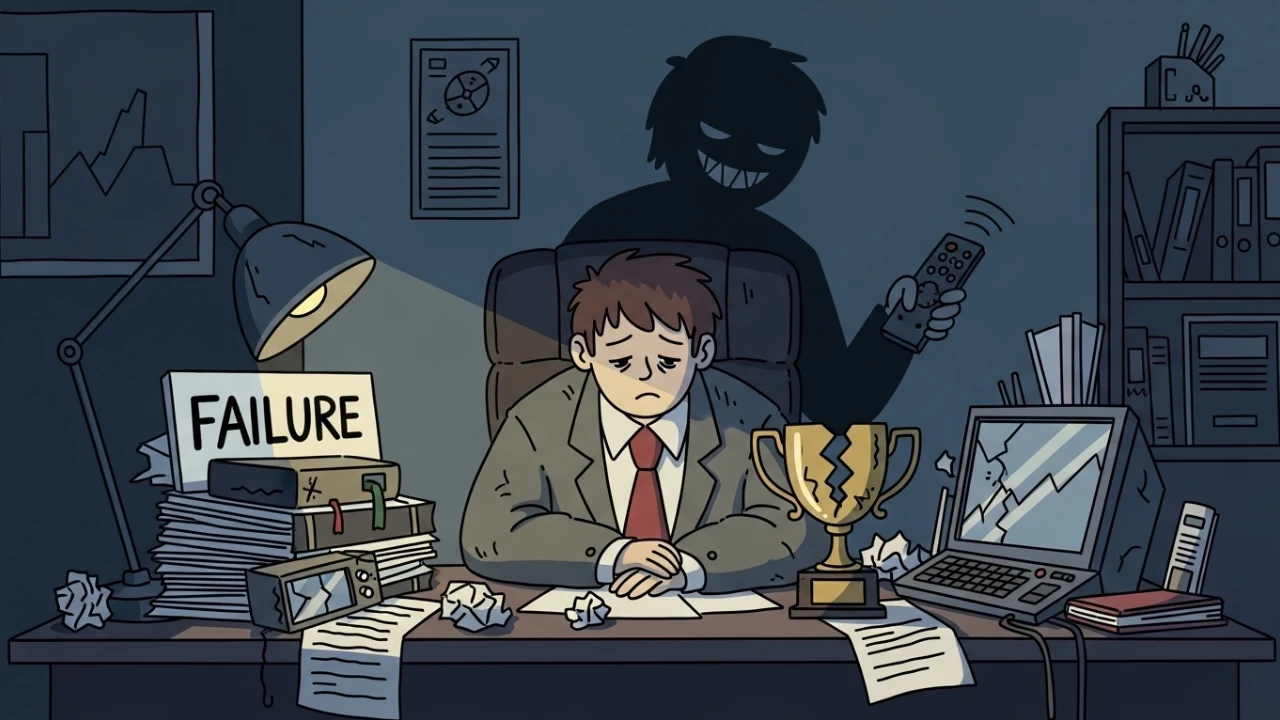
A proposta de um "Chief Failure Officer" (CFO) ou Diretor de Fracassos pode parecer uma provocação publicitária, mas em ambientes corporativos e de engenharia caracterizados por alta incerteza, ela resolve um problema técnico de gestão: decisões sem feedback rápido acumulam desperdício de engenharia, geram retrabalho crônico e atrasam a resposta competitiva frente ao mercado.
O objetivo deste papel não é normalizar a mediocridade ou incentivar o erro descuidado. Pelo contrário: é reduzir drasticamente o custo do aprendizado por meio de experimentação controlada, limites de risco claros e governança de dados.
1. O alinhamento com frameworks de mercado#
Para profissionais técnicos de DevOps, SRE e Gestão de Riscos, o termo "Failure" pode parecer desalinhado com frameworks rígidos de conformidade (como COBIT, ITIL v4 ou PMI). No entanto, o papel do Chief Failure Officer atua como uma ponte integradora entre a governança tradicional e os métodos de inovação acelerada.
A tabela abaixo demonstra como o escopo do CFO se mapeia e complementa os frameworks e conceitos já existentes:
| Conceito / Framework | Foco Principal | Conexão com o Chief Failure Officer |
|---|---|---|
| SRE (Site Reliability Engineering) | Confiabilidade, MTTR, SLAs, SLOs e Error Budgets. | O CFO utiliza o conceito de Error Budget (orçamento de erro) para determinar o limite aceitável de risco para novos deploys e experimentos em produção, promovendo Blameless Postmortems (retrospectivas sem culpa). |
| Lean Startup | Ciclo de feedback Construir-Medir-Aprender e Pivô. | O CFO sistematiza e operacionaliza esse ciclo na engenharia, definindo SLAs para o pivô ou descontinuação de features inviáveis. |
| Chaos Engineering | Testar resiliência injetando falhas controladas em produção. | O CFO apoia a execução de Game Days para validar a resiliência do sistema e garantir que falhas planejadas gerem aprendizado documentado antes de incidentes reais. |
| Agile (Scrum / Kanban) | Ciclos curtos de entrega, retrospectivas. | O CFO estende as retrospectivas para além do processo do time, focando na validação empírica do valor de negócio gerado pelo produto. |
| Chief Risk Officer (CRO) | Prevenção de riscos operacionais, segurança e conformidade. | Enquanto o CRO foca em mitigar ameaças à conformidade e à segurança da informação, o CFO atua no risco de oportunidade, o objetivo é que o medo do fracasso não paralise a inovação. |
| Chief Learning Officer (CLO) | Capacitação, treinamentos e desenvolvimento de pessoas. | O CLO treina a força de trabalho; o CFO cria a infraestrutura de dados (Failure Library) para que os aprendizados técnicos e de produto fiquem salvos no sistema operacional da empresa. |
2. Framework operacional em 5 blocos#
Um erro comum é tratar a cultura de experimentação como um conjunto de palestras motivacionais. Para que o aprendizado ocorra de forma previsível, implementamos um framework prático estruturado em cinco blocos:
Bloco 1: Hipótese com métrica e prazo (timebox)#
Toda nova iniciativa técnica ou de produto deve ser descrita como uma hipótese falseável antes de qualquer linha de código ser escrita.
- Quem Executa: Product Managers e Tech Leads.
- Ferramentas: Jira, Linear ou templates do Confluence.
- Exemplo:
- Hipótese: Substituir o fluxo de checkout monolítico por uma SPA (Single Page Application) reduzirá o abandono de carrinho.
- Métrica Primária: Redução do abandono em no mínimo 5%.
- Prazo (Timebox): 14 dias de coleta de dados em produção com tráfego dividido.
Bloco 2: Orçamento de risco por experimento (risk budgeting)#
Cada teste recebe um teto de perda tolerável. Se o orçamento for estourado, o experimento é interrompido ou revertido automaticamente.
- Quem Executa: SREs e DevOps Engineers.
- Ferramentas: PostHog, LaunchDarkly, Split.io ou Feature Flags customizadas.
- Exemplo: O experimento de checkout SPA só pode afetar no máximo 10% dos usuários. Se a taxa de erros HTTP 5xx na API de pagamento subir acima de 0.5% por mais de 5 minutos, a flag do experimento realiza o rollback automático.
Bloco 3: Ritual semanal de aprendizado#
Um fórum de alta densidade técnica no qual os times apresentam resultados dos experimentos concluídos na semana.
- Participantes: Engenheiros de Software, Product Owners e Stakeholders de Negócio.
- Agenda Fixa:
- O que testamos e qual era a hipótese inicial?
- O que os dados nos disseram (sucesso ou falha)?
- Qual o aprendizado documentado?
- Descontinuamos a iniciativa ou avançamos para roll-out completo?
Bloco 4: Indicadores de velocidade de aprendizado#
Métricas voltadas a avaliar a eficiência do próprio processo de inovação.
- Quem Coleta: Gestores de Engenharia e CFO.
- Ferramentas: Dashboards do Grafana integrados ao fluxo do GitHub/Jira.
Bloco 5: Failure library (biblioteca de aprendizados)#
Um repositório de conhecimento centralizado e versionado que guarda o histórico de todas as falhas, testes descontinuados e postmortems de infraestrutura.
- Quem Mantém: Toda a equipe, sob curadoria do CFO.
- Ferramentas: GitHub Wiki, Notion ou repositórios Git dedicados em Markdown.
3. Métricas de aprendizado: como operacionalizar#
Para que a governança do CFO funcione, as métricas devem ser quantificáveis. A seguir, detalhamos a operacionalização prática das métricas recomendadas:
A) Frequência de experimentos ($FE$)#
Mede o volume de hipóteses testadas por unidade de tempo por equipe. $$\text{FE} = \frac{\text{Número de Experimentos Concluídos e Analisados}}{\text{Semana}}$$
- Como coletar: Tags específicas em tasks concluídas no Jira/Linear (ex:
type:experiment). - Baseline Saudável: 1 a 2 experimentos por squad por semana.
B) Tempo médio para decisão (MTTD - mean time to decision)#
Mede a agilidade organizacional em descontinuar uma iniciativa inviável ou aprovar uma bem-sucedida. $$\text{MTTD} = \text{Data de Conclusão/Cancelamento} - \text{Data de Início do Experimento}$$
- Como coletar: Logs de ativação da Feature Flag em produção comparados com o commit de rollback/merge.
- Baseline Saudável: $< 14$ dias para hipóteses simples de produto; $< 30$ dias para migrações de arquitetura de software.
C) Taxa de consumo do error budget ($TCEB$)#
Indica se a velocidade de inovação está colocando em risco a estabilidade do sistema. $$\text{TCEB} = \frac{\text{Minutos de Inatividade Registrados}}{\text{Minutos de Inatividade Permitidos no SLO (Mensal)}} \times 100$$
- Como coletar: Prometheus / Grafana avaliando o tempo de resposta e uptime das rotas.
- Baseline Saudável: Consumo linear ao longo do mês. Se chegar a 100% antes do fim do ciclo, novos deploys não experimentais são bloqueados automaticamente.
D) Taxa de reúso de aprendizados ($TRA$)#
Mede a eficiência da Failure Library no pre-mortem. $$\text{TRA} = \frac{\text{Projetos que alteraram escopo devido a falha histórica catalogada}}{\text{Total de Novos Projetos Iniciados}}$$
- Como coletar: Documentação de pre-mortem com links obrigatórios da Failure Library nas propostas arquiteturais (RFCs).
Conexão com métricas DORA (DevOps research and assessment)#
A implementação do framework CFO impacta diretamente as métricas DORA:
- Frequência de Implantação: Aumenta significativamente devido ao uso de deploys menores e controlados via Feature Flags.
- MTTR (Mean Time to Restore): Reduzido drasticamente, pois experimentos falhos são revertidos automaticamente pelas flags de controle em segundos, sem necessidade de hotfixes manuais de emergência.
4. Estudo de caso: migração de VM para Kubernetes#
Para compreender a eficácia deste modelo, analisamos a migração da arquitetura de uma plataforma de e-commerce de servidores VM legados para um cluster Kubernetes gerenciado.
Cenário de partida (sem o modelo do CFO)#
A empresa tentou realizar a migração em formato big-bang. A migração levou 6 meses para ser preparada. Quando o tráfego foi migrado, erros de concorrência não mapeados nos microsserviços derrubaram o banco de dados. O rollback demorou 4 horas para ser executado manualmente, gerando prejuízo reputacional e financeiro. Os postmortems focaram em apontar culpados pela queda, resultando em times acuados e paralisação dos deploys.
Novo cenário (com o modelo do CFO)#
Sob a ótica do Chief Failure Officer, a migração foi redesenhada como uma série de experimentos de baixo acoplamento:
- Orçamento de Risco Estabelecido: Permissão de no máximo 2% de erros de timeout HTTP durante a transição, com 0.1% de limite do Error Budget global consumido por dia de teste.
- Canary Deploy e Feature Flags: Criação de um proxy inteligente de rede. O tráfego foi migrado incrementalmente (1%, 5%, 10%).
- Falha Controlada: Aos 10% de tráfego, o microsserviço de recomendação de produtos falhou ao instanciar pods sob carga. O proxy detectou a latência média acima de 500ms e fez o desvio automático de volta para as VMs sem intervenção humana (MTTR de 45 segundos).
- Ritual de Postmortem Sem Culpa (Blameless): O time reuniu-se no dia seguinte para documentar que a política de escalonamento automático (HPA) estava mal dimensionada na CPU. O caso foi documentado na Failure Library.
Resultados quantitativos do caso:#
- Frequência de Deploy: Passou de 1 deploy a cada 15 dias para 12 deploys por dia.
- MTTR Médio: Reduzido de 4 horas (no incidente big-bang) para 45 segundos (reversão automatizada).
- Desperdício de Horas de Engenharia: Redução de 30% em retrabalho técnico, pois falhas foram capturadas e tratadas em ambientes com baixo raio de ação.
5. Riscos, limitações e antipadrões#
A implementação de uma cultura baseada em CFO possui desafios reais que exigem mitigação ativa por parte da liderança:
- Lei de Goodhart (Métricas Distorcidas):
- Risco: Se o time for avaliado pela quantidade de experimentos criados, passará a criar testes inúteis ou duplicados apenas para atingir a meta.
- Mitigação: O CFO deve avaliar a qualidade do aprendizado gerado. Um experimento bem formulado precisa gerar uma RFC ou mudança de código efetiva, seja para descartar ou aprovar a hipótese.
- Resistência Cultural e "Falsa Segurança":
- Risco: Colaboradores acostumados com punições formais podem desconfiar do processo e esconder falhas menores.
- Mitigação: A liderança executiva deve abrir os rituais apresentando suas próprias falhas estratégicas e as lições extraídas.
- Paralisia por Análise (Over-documentation):
- Risco: Documentar rigorosamente pequenas falhas irrelevantes do dia a dia, drenando a velocidade do time.
- Mitigação: Definir limiares claros. Somente experimentos formais (que envolveram feature flags ou investimentos significativos) ou incidentes que afetaram SLOs de produção devem gerar registros na biblioteca.
- Fricção entre Equipes:
- Risco: Times experimentais com alta taxa de falhas toleradas gerando retrabalho para equipes de operação de legado estáveis.
- Mitigação: Acoplamento flexível de arquitetura (API-first) e isolamento dos ambientes de teste com contratos de API rígidos.
Apêndice: template de protocolo de experimento e registro de falha#
Abaixo, disponibilizamos o modelo operacional adotado para documentar novos experimentos e registrar seus resultados de forma padronizada. Copie este template para o repositório ou wiki do seu time.
# [EXP-000] PROTOCOLO DE EXPERIMENTO E REGISTRO DE FALHA

## 1. FASE de PLANEJAMENTO (pre-mortem)
* **Responsável pelo Experimento**: [Nome do Engenheiro/Product Lead]
* **Data de Início**: [Data]
* **Timebox Recomendado**: [Ex: 10 dias]

### 1.1 declaração da hipótese
> *Nós acreditamos que [Ação/Mudança técnica ou de produto]*
> *Para resolver o problema de [Contexto/Problema detectado]*
> *E resultará em [Efeito esperado]*

### 1.2 métricas de sucesso e validação
* **Métrica Primária (KPI)**: [Ex: Taxa de conversão, Latência P99, Taxa de erros HTTP]
* **Baseline Atual (Métrica antes da alteração)**: [Ex: 350ms, 94.2%]
* **Meta de Validação**: [Ex: Latência < 250ms, Conversão > 96%]

### 1.3 orçamento de risco (risk budget & guardrails)
* **Impacto Máximo Permitido (Raio de Ação)**: [Ex: Máximo 5% de tráfego de produção]
* **Condições de Rollback Imediato (Kill Switches)**:
  - [ ] Taxa de erros HTTP 5xx acima de X% por mais de Y minutos.
  - [ ] Consumo de CPU do cluster acima de Z%.
  - [ ] Reclamações de usuários no suporte excedendo W por hora.

---

## 2. FASE de execução e RESULTADOS (post-mortem)
* **Data de Conclusão**: [Data]
* **Resultado Geral**: [  ] HIPÓTESE VALIDADA (Avançar para Roll-out) | [  ] HIPÓTESE REJEITADA/FALHA

### 2.1 dados coletados
[Insira aqui gráficos do Grafana, logs, tabelas de A/B testing ou métricas de negócio obtidas]

### 2.2 análise da falha (se aplicável)
* **Por que a hipótese falhou?** [Explicação técnica clara e sem culpados]
* **O que mitigou o estrago?** [Ex: O rollback automático via feature flag atuou em 2 minutos]

### 2.3 aprendizados reutilizáveis para a biblioteca (failure library)
1. [Lição aprendida 1: Ex: O banco de dados Postgres não suporta esta query de busca sem índice parcial]
2. [Lição aprendida 2: Ex: O usuário final ignora o botão vermelho no mobile devido ao teclado virtual]

### 2.4 ações de engenharia derivadas
* [ ] Task Jira/Linear: [Link para task de correção definitiva ou remoção do código órfão]
* [ ] Atualização de documentação: [Link para wiki de arquitetura]
Referências bibliográficas#
- EDMONDSON, Amy C. A Organização Sem Medo: Criando Segurança Psicológica no Trabalho para Inovação, Aprendizado e Crescimento. Alta Books, 2019. (Estudos empíricos sobre o impacto da tolerância ao erro na performance).
- BEYER, Betsy et al. Site Reliability Engineering: How Google Runs Production Systems. O'Reilly Media, 2016. (Modelos práticos de Error Budgets e Blameless Postmortems).
- RIES, Eric. A Startup Enxuta. Sextante, 2011. (Definição científica do ciclo Construir-Medir-Aprender).
- FORSGREN, Nicole; HUMBLE, Jez; KIM, Gene. Accelerate: The Science of Lean Software and DevOps. IT Revolution Press, 2018. (Evidências empíricas sobre métricas DORA e o impacto de deploys seguros no desempenho organizacional).
Este artigo foi útil?
Deixe uma reação rápida para apoiar o conteúdo:
Veja também

Este post está licenciado sob CC BY-NC.
Comentários
Participe da discussão abaixo.
0 comentários